Скачать PDF OCR Free – Бесплатный OCR-инструмент для поисковых PDFs
Обзор
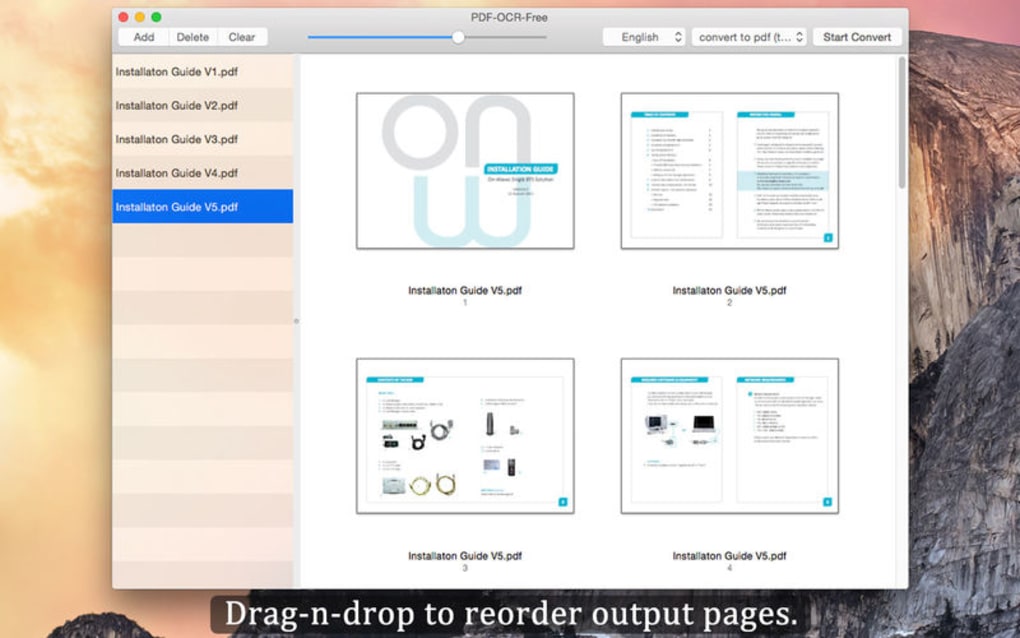
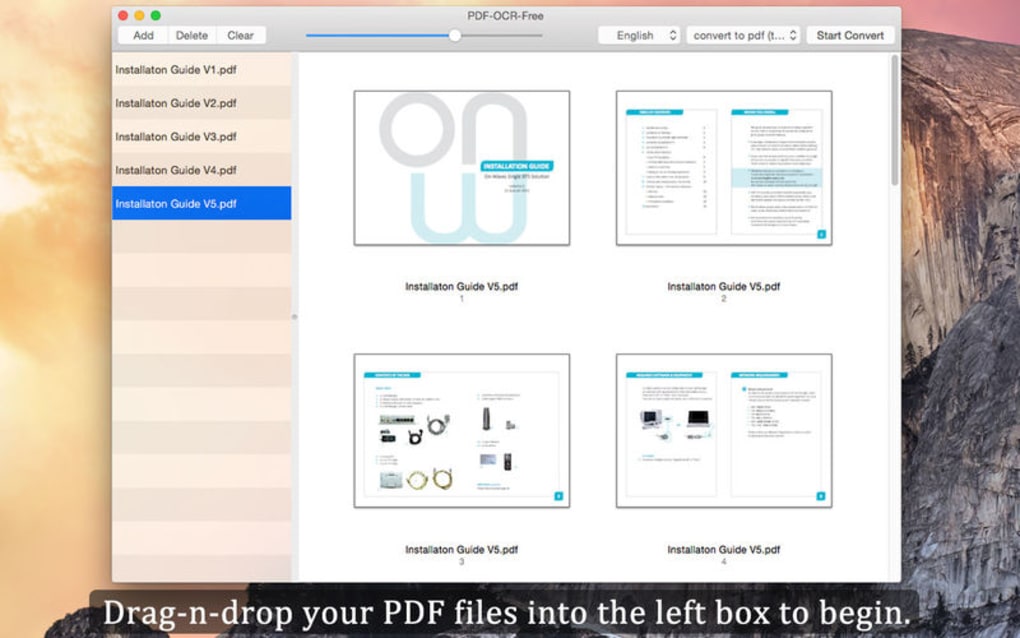
PDF OCR Free — это легкое, бесплатное приложение, предназначенное для преобразования статических PDF‑документов в полностью поисковые файлы с помощью оптического распознавания символов (OCR). Программа использует интерфейс drag‑and‑drop, позволяющий пользователям быстро добавить один или несколько PDF‑файлов для конвертации, устраняя необходимость в сложных меню или техническом жаргоне. Независимо от того, студент ли вы, желающий индексировать конспекты лекций, профессионал, работающий с контрактами, или кто‑то, кому нужно извлечь текст из отсканированных документов, PDF OCR Free предлагает простое решение, работающее в Windows, macOS и Linux. Инструмент поддерживает 45 языков — включая английский, французский, немецкий, португальский, итальянский и испанский — чтобы пользователи по всему миру могли точно извлекать текст из многоязычных источников. Доступны три режима экспорта: «Только текст», который извлекает чистый текст; «Текст на изображении», который накладывает распознанный текст на оригинальное изображение для сохранения визуального вида; и «Только изображение», который сохраняет оригинальную графику без добавления поисковых слоёв. Пакетная обработка позволяет ставить в очередь несколько файлов, экономя часы по сравнению с ручной конвертацией. Даже зашифрованные PDF‑файлы, защищённые от редактирования, копирования или печати, могут быть обработаны при условии ввода правильного пароля. Результатом является поисковый, редактируемый PDF, который бесшовно интегрируется со стандартными PDF‑просмотрщиками и системами управления документами. Поскольку приложение бесплатно и не требует подключения к интернету после установки, оно уважает конфиденциальность пользователей, предлагая безопасный офлайн‑движок OCR.
Ключевые функции и преимущества
- Интерфейс drag‑and‑drop для мгновенного добавления файлов.
- Поддержка 45 языков, охватывающих основные европейские и азиатские письменности.
- Три режима экспорта: только текст, текст на изображении, только изображение.
- Пакетное преобразование для обработки десятков PDF за одну операцию.
- Возможность расшифровки PDF‑файлов, защищённых паролем (пароль требуется).
- Офлайн‑обработка гарантирует конфиденциальность и отсутствие передачи данных на внешние серверы.
- Лёгкий установщик < 10 МБ, минимальное влияние на систему.
- Кроссплатформенная совместимость: Windows 10/11, macOS 10.13+, Linux (Ubuntu, Fedora).
- Автоматическое определение языка сокращает время настройки.
- Отсутствие скрытых платежей, рекламы и подписок.
Сочетание этих функций создаёт инструмент, одновременно мощный и доступный. Для пользователей, которые часто получают отсканированные контракты, счета или академические статьи, возможность преобразовать целую стопку PDF в поисковые документы одним щелчком может значительно повысить эффективность рабочего процесса. Поддержка языков особенно ценна для международных команд, поскольку OCR‑движок может распознавать символы из разных алфавитов без необходимости установки отдельных языковых пакетов. Три варианта экспорта дают контроль над конечным видом: выбирайте «Только текст», когда нужен лёгкий поисковый файл; выбирайте «Текст на изображении», чтобы сохранить оригинальную раскладку и одновременно включить поиск; или выбирайте «Только изображение», если нужен визуальный реплика без поискового слоя (полезно для архивных целей). Пакетная обработка позволяет указать папку с PDF, задать желаемый режим вывода и дать программе выполнить остальное, освобождая вас для более ценных задач. Наконец, офлайн‑характер PDF OCR Free гарантирует, что конфиденциальные документы никогда не покинут ваш компьютер, что особенно важно для юридических, медицинских или финансовых специалистов.
Установка, использование и совместимость
Пошаговое руководство по установке
Установка PDF OCR Free преднамеренно проста. Сначала скачайте установщик с официального сайта. Размер файла менее 10 МБ, поэтому загрузка завершается быстро даже при медленном соединении. Для пользователей Windows запустите файл .exe и следуйте подсказкам на экране: примите лицензионное соглашение, выберите папку установки (по умолчанию подходит большинству) и нажмите «Install». Пользователи macOS получат образ .dmg; дважды щёлкните его, перетащите значок приложения в папку Applications и запустите программу. Пользователи Linux могут скачать архив .tar.gz, распаковать его и запустить предоставленный shell‑скрипт, либо установить через пакет .deb/.rpm, если он доступен. Установщик не содержит нежелательных панелей инструментов или рекламного ПО, соблюдая обещание бесплатного и чистого продукта.
Как эффективно использовать PDF OCR Free
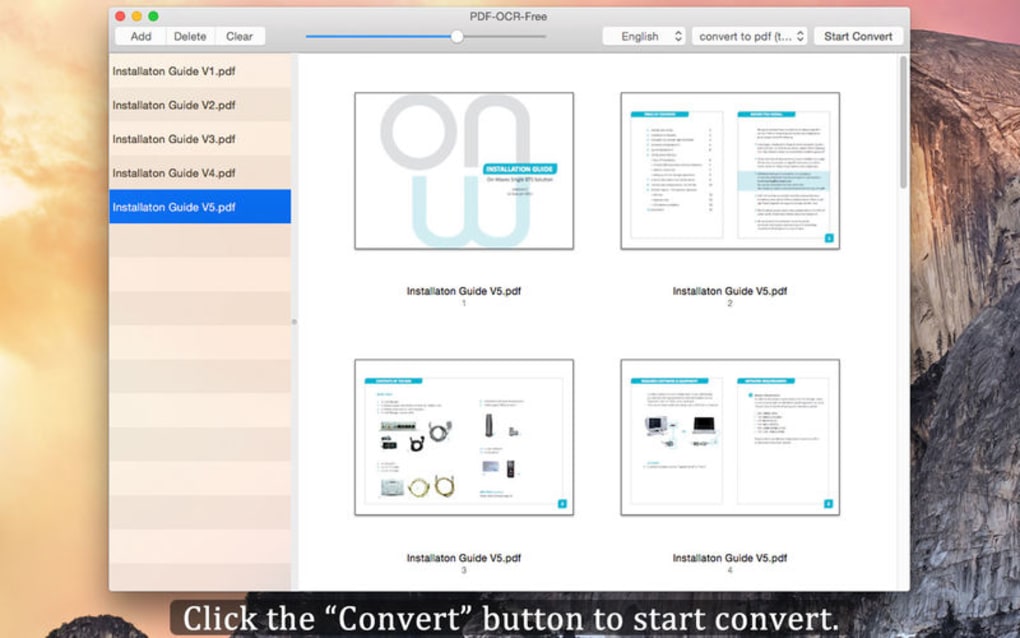
После установки запустите приложение. Главное окно показывает большую зону «Drop PDFs Here». Перетащите один PDF или целую папку в эту область. Программа автоматически определит язык каждого документа; вы можете переопределить его, выбрав язык из выпадающего списка, если знаете основной язык содержимого. Выберите желаемый режим экспорта с помощью трёх радиокнопок в нижней части окна. Для пакетных задач можно задать глобальный режим, применимый ко всем файлам, либо настроить каждый файл индивидуально, нажав значок «Settings» рядом с его именем. Если вы обрабатываете зашифрованные PDF, нажмите кнопку «Unlock» и введите пароль; инструмент расшифрует файл, выполнит OCR и при желании заново зашифрует результат. После настройки параметров нажмите кнопку «Start». Полоса прогресса отображает статус конвертации в реальном времени, а после завершения файлы‑результаты появляются в указанной вами папке (по умолчанию — подпапка «OCR_Output» рядом с исходными файлами). Вы можете открыть любой результат прямо из приложения, щёлкнув значок «Open», который запустит ваш стандартный PDF‑просмотрщик с готовым к использованию поисковым документом.
Системные требования и поддерживаемые операционные системы
PDF OCR Free работает на следующих платформах:
- Windows 10, Windows 11 (64‑бит)
- macOS 10.13 High Sierra и новее (Intel и Apple Silicon)
- Дистрибутивы Linux с glibc 2.17+ (тестировано на Ubuntu 20.04+, Fedora 33+)
Минимальные аппаратные требования скромны: двухъядерный процессор, 2 ГБ ОЗУ и 100 МБ свободного места на диске для самого приложения плюс дополнительное пространство для обработанных PDF. OCR‑движок использует процессор; для больших пакетов современный многоядерный процессор ускорит конвертацию. После установки интернет‑соединение не требуется, что делает программу идеальной для защищённых сред или офлайн‑рабочих процессов.
Плюсы, минусы и отзывы пользователей
Плюсы
- Полностью бесплатно, без скрытых платежей или подписок.
- Интуитивный интерфейс drag‑and‑drop снижает кривую обучения.
- Поддержка широкого спектра языков (всего 45).
- Пакетная обработка экономит время при работе с большими наборами документов.
- Офлайн‑режим защищает конфиденциальные данные.
- Обрабатывает PDF‑файлы, защищённые паролем, при наличии пароля.
- Лёгкий объём установки.
- Кроссплатформенная поддержка обеспечивает доступность для большинства пользователей.
Минусы
- Продвинутая предобработка изображений (например, исправление наклона, удаление шума) ограничена.
- Отсутствует встроенный PDF‑редактор для пост‑OCR корректировок.
- Автоопределение языка иногда может ошибочно распознать редкие скрипты.
- Отсутствует интерфейс командной строки для продвинутых пользователей.
- Нет облачной интеграции для автоматического резервного копирования или совместного использования.
Отзывы пользователей на форумах и в каталогах программ постоянно хвалят PDF OCR Free за простоту и надёжность. Многие отмечают скорость пакетных конвертаций и точность OCR‑движка для множества языков. Некоторые продвинутые пользователи просят добавить инструменты улучшения изображений, но базовый функционал удовлетворяет потребности большинства людей и небольших компаний. В целом приложение имеет высокий рейтинг 4.5 из 5 звёзд, отражающий большую удовлетворённость своей пользовательской базой.
Review: “PDF OCR Free предоставляет именно то, что обещает — быстрый, точный OCR без каких-либо затрат. Режим пакетной обработки делает его незаменимым для составления моих еженедельных отчетов.”
Часто задаваемые вопросы
PDF OCR Free действительно бесплатен или есть скрытые платежи?
Да, PDF OCR Free полностью бесплатен. Нет скрытых подписок, покупок внутри приложения или рекламы. Разработчик предлагает программное обеспечение как ориентированное на сообщество средство.
Можно ли использовать PDF OCR Free на Mac с Apple Silicon?
Абсолютно. Версия для macOS является универсальным бинарным файлом, что означает нативную работу как на Mac с процессорами Intel, так и на Apple Silicon (M1/M2).
Насколько точен OCR для нелатинских скриптов, таких как кириллица или арабский?
OCR‑движок поддерживает 45 языков, включая кириллицу, арабский, греческий и несколько азиатских скриптов. Точность сопоставима с другими ведущими бесплатными OCR‑инструментами, хотя результаты улучшаются при наличии PDF высокого разрешения.
Могу ли я конвертировать зашифрованные PDF без снятия пароля?
Да. Если вы знаете пароль, вы можете ввести его в диалоговом окне «Разблокировать». Программа временно расшифрует файл, выполнит OCR и затем заново зашифрует результат, если вы решите сохранить защиту.
Есть ли ограничение на количество файлов, которые можно обработать в пакете?
Твердого ограничения нет. Практический предел зависит от памяти и процессора вашей системы. Пользователи успешно обрабатывали сотни PDF в одном пакете без проблем.
Заключение и призыв к действию
PDF OCR Free выделяется как надёжное, удобное решение для любого, кто хочет преобразовать статические PDF в поисковые, редактируемые документы без каких‑либо затрат. Его многоязычная поддержка, пакетная обработка и офлайн‑безопасность делают его практичным выбором для студентов, профессионалов и небольших компаний. Предлагая три гибких режима экспорта и возможность работать с PDF, защищёнными паролем, инструмент покрывает большинство типичных OCR‑сценариев, оставаясь при этом достаточно простым для новичков. Если вы ищете безопасный, экономичный способ сделать свою библиотеку PDF поисковой, скачайте PDF OCR Free сегодня и ощутите рост продуктивности, который дают поисковые документы.